

1 、程序没有发生堆内存异常
2 、内存显示(Memory Usage (bytes)一直在增加( kubernetes dashboard )
3 、jvm 参数设置 JAVA_TOOL_OPTIONS
-XX:+UseContainerSupport -XX:InitialRAMPercentage=80.0
-XX:MaxRAMPercentage=80.0 -XX:+PrintGCDetails
-XX:+PrintGCDateStamps -Xloggc:/data/logs/app/gc.log
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/data/logs/app/dump.hprof
第 1 条附言 · 2023 年 9 月 18 日
pod
      resources:
        limits:
          cpu: '4'
          memory: 8G
        requests:
          cpu: 50m
          memory: 500m
第 2 条附言 · 2023 年 9 月 18 日
JDK8版本:1.8.0_345
Reason: OOMKilled
Exit Code: 137
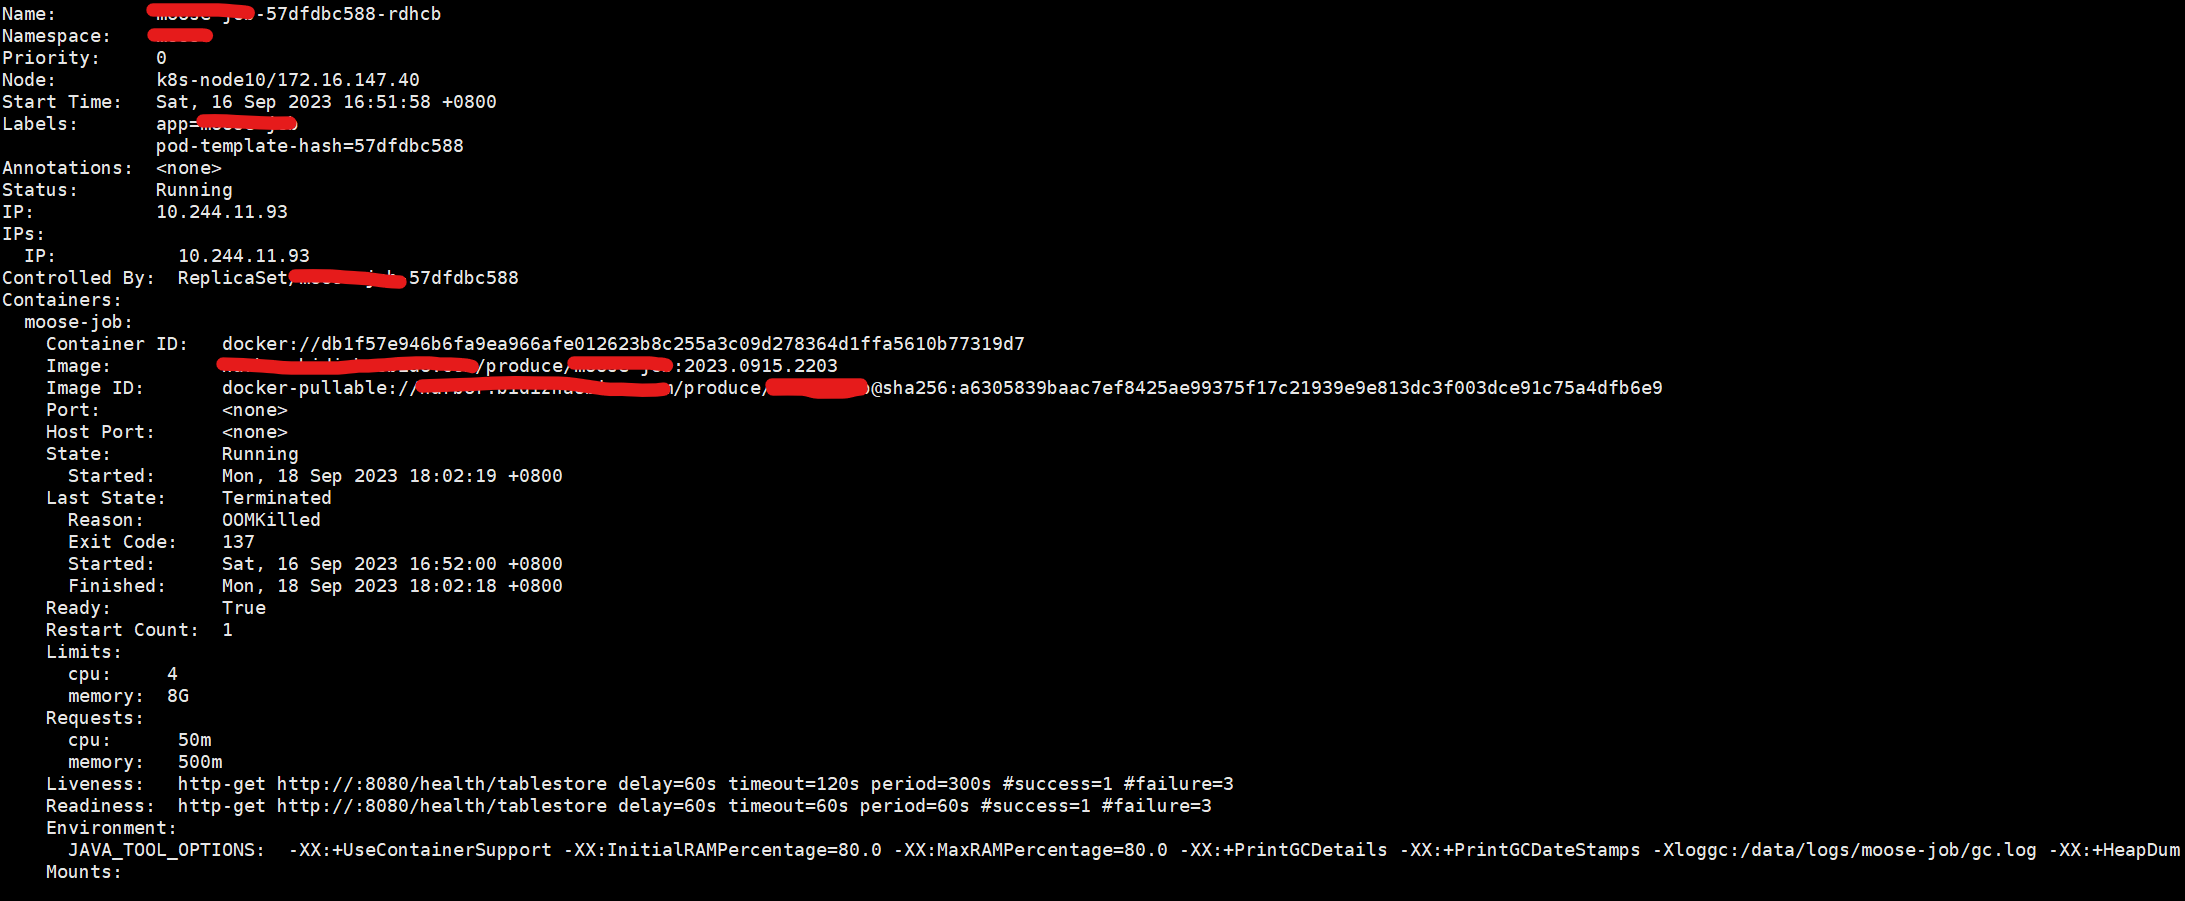
第 3 条附言 · 2023 年 9 月 18 日
arthas
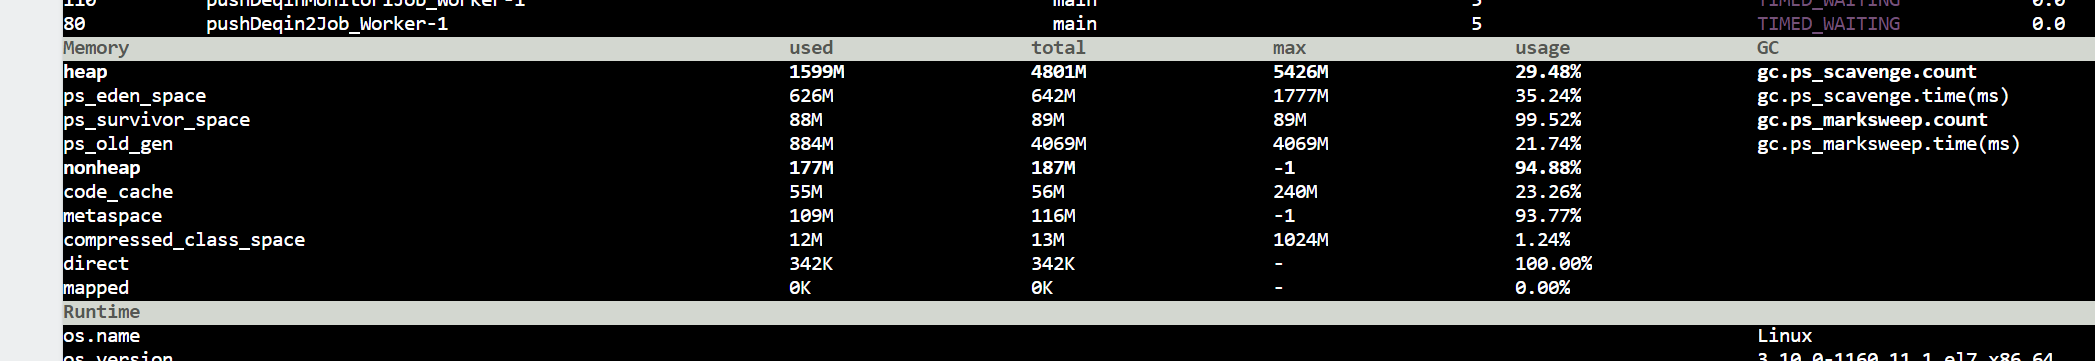
45 条回复 • 2023-12-15 13:24:02 +08:00
 |
1
kevinlia0 2023 年 9 月 18 日 via Android
会不会是你分配给 pod 内存不够呢。
|
 |
2
Frankcox 2023 年 9 月 18 日
重启的时候看下事件或者 Pod 的 status ,或者你看 dashboard 看下内存是不是超了
|
 |
3
ixx 2023 年 9 月 18 日
看一下重启的时候 k8s 记录的 pod 日志 有没有 oomkilled
一般情况如果不是程序本身结束进程重启就是触发了 k8s 的 oomkilled 机制 |
 |
4
beiluo 2023 年 9 月 18 日
大概率是 OOMKilled ,查看 pod status 可以看到 exit code 和 reason, exit code 可以参考 https://komodor.com/learn/exit-codes-in-containers-and-kubernetes-the-complete-guide/
如果不是,可以查看 previous pod log 看下是不是 jvm crash 出 core dump 了。 |
 |
5
imyasON 2023 年 9 月 18 日
我遇到过,也是不知道什么原因。我容器内存是 1 - 2G ,Java -Xms xmx 设置的都是 2g, 然后 OPTIONS 加了一个 gc 类型 UseG1GC 。上线后出现和你一样的情况,莫名其妙的重启,后来我把-Xms1500m -Xmx1500m 和 gc 删掉让它用默认的,目前算是恢复正常,没有重启了。
|
 |
6
fisherwei 2023 年 9 月 18 日
java 版本是 1.8.191 以上吗?
|
 |
7
jerry2233 2023 年 9 月 18 日
`kubectl logs --previous POD_NAME`
|

 |
12
freemoon 2023 年 9 月 18 日
OOM 是代码问题,不是 k8s 问题( k8s 也解决不了)。检查程序哪里发生内存泄露,这个在 java 生态里面不是有很多工具能用吗
|
 |
13
Dream95 2023 年 9 月 18 日
pod 内除了 Java 有没有其它进程占用了内存
|
 |
14
G2bN4dbX9J3ncp0r 2023 年 9 月 18 日
@dunhanson 加内存呗
|
 |
15
matepi 2023 年 9 月 18 日
jvm 总体不要设过容器一半。各种 gc 相关参数打开、oom 时就能产生 heapdump ,拿出来分析内存溢出/泄露对象
还有:@imyasON 不要 不要 不要 随便随便就设置等同的 xms 和 xmx 。当堆内用量情况很平稳没有升代、长时间不需要 fullgc ,没有 fullgc 就有不能触发挂载在 finalizer 上的资源回收,可能导致包括堆外溢出等各种各样的资源耗尽问题。在确认没有堆外资源、没有 finalizer 依赖等等情况下,已经做过深度优化的基础上再考虑 xms=xmx 的设定。 |
 |
16
chendy 2023 年 9 月 18 日
容器内存限制 500m 的话,堆最大给 250m ,也就是堆内堆外 1:1 比较稳妥,然后上监控看看实际使用情况再酌情往大了给
|
 |
17
Georgedoe 2023 年 9 月 18 日
java8 读的不是容器内存 , 是宿主机内存 , 容易堆溢出 , 得设置 Xms 和 Xmx
|
 |
19
julyclyde 2023 年 9 月 18 日
@dunhanson 都 jdk8 了还能有多新啊
前几天有另一个帖子说过了,jdk8 不认识 cgroup 的限制,但是看/proc/meminfo 看到的又不是“给自己的”而是“整机的”资源,导致一些自动设定的容量大小参数计算错误 |
 |
20
cctv6 2023 年 9 月 18 日
使用了 MaxRAMPercentage=80.0 后,容器里面的 jvm 最大堆内存是多少呢?
jdk8 现在应该还不认识 cgroup2 的资源限制的,目前应该是只能支持 v1 。如果节点上使用的是 cgroup2 的话,在使用 MaxRAMPercentage 的时候,会按照节点的内存大小来计算百分比,而不是 pod 资源限制的内存大小来计算。 |
|
21
cctv6 2023 年 9 月 18 日  1 |
 |
22
notwaste 2023 年 9 月 18 日
看描述是 OOM Killer 的问题,容器是否有其他程序占用内存,站内搜下 OOM Killer 可能会有些收获
|
 |
23
anubu 2023 年 9 月 18 日
可以看看 #20 的回复。我们在 k8s 环境碰到过这个问题,JDK8 和 cgroup2 有兼容性问题,无法识别容器的 limit 导致 OOM 。可以考虑升级 JDK ,降级 cgroup ,手动指定 xmx 等方法。
|
 |
26
v2nika 2023 年 9 月 18 日
kubectl describe pod YOUR_POD_NAME
可以看到 restart 的原因. |
|
27
v2nika 2023 年 9 月 18 日
有一种情况是 pod 被驱逐了, 会导致 pod 名字变了, 就找不到了, 可以通过 kubectl get events 查一下事件记录.
另外还有可能是 node 内存不够导致 pod 被系统 oom 杀掉了 (我猜大概率是这个), 这个时候是找不到任何日志的, 因为 jvm/kubelet 都没有机会记录这个事件. 发生的原因是你的 memory 的 request 和 limit 写的不一样, memory 属于不可压缩资源, k8s 没有办法在已经申请后调度. 另外你的 cpu limit 配置的是 4, 这个时候的 gc 算法默认是 G1 (<= 1 的时候是 Serial GC), G1 会在达到你配置的最大堆内存的一个比例前持续增加 old gen 的内存占用 (即使这些对象已经没有引用), 直到发生 mixed gc 或者 full gc. |
|
28
v2nika 2023 年 9 月 18 日
不过我看你的 InitialRAMPercentage 配置和 MaxRAMPercentage 配置一样, 不太可能是上面说的那个.
|
 |
35
Sezxy 2023 年 9 月 18 日
我的内存最大都只设置到 70%,你 80%的话,如果 POD 内存不大,那剩余的内存不多了,可能一些堆外内存就容易占满。建议根据实际情况调整。
|
 |
36
YzSama 2023 年 9 月 18 日 via iPhone
1 建议升级 11 ,2 最好的方式是容器自适应。我之前也是,后面不设最大 max 和 min 了。基本不会重启了
|
 |
37
cheng6563 2023 年 9 月 18 日
你 Java 服务没用 jni 那些 native 内存管理的话,只靠-Xmx 限制就够用了,k8s 的 pod 限制可以去掉或者设置很大。
|
|
38
beiluo 2023 年 9 月 19 日
@dunhanson #33 看了下 arthas 的截图,可以考虑把 Xmx 的 75%降到 50%左右试试,可能会增加一些 GC 频率,但是服务更稳定。一个 docker 容器里面会有 Linux 系统本身的占用+JVM 堆占用+JVM 堆外占用(包括 metaspace ,code cache ,native 等)堆占用 75%之后,其实留给其他部分的并不多了。个人理解。
|
 |
39
cmai 2023 年 9 月 19 日
看不到阿尔萨斯的图了,从堆外内存泄漏着手吧
|
|
40
notwaste 2023 年 9 月 19 日
https://www.v2ex.com/t/740570
“问题出发点不在修改方便上面,Xmx 跟容器平台 memory limit 不契合是关键。因为 JVM 进程内存不严格的说要等于 Xmx + 线程数 * Xss + native allocation 等等等,如果 Xmx 是设置好的,跟 limit 一样,实际上堆内存还远没用到 Xmx 就会到达 memory limit 被 kubernetes exit 137 这个值必须要动态” 可以看下 7 楼里面引用的答案和评论 |
 |
44
freebird1994 2023 年 9 月 21 日 via Android
我也遇到了一样的问题😢
|
