

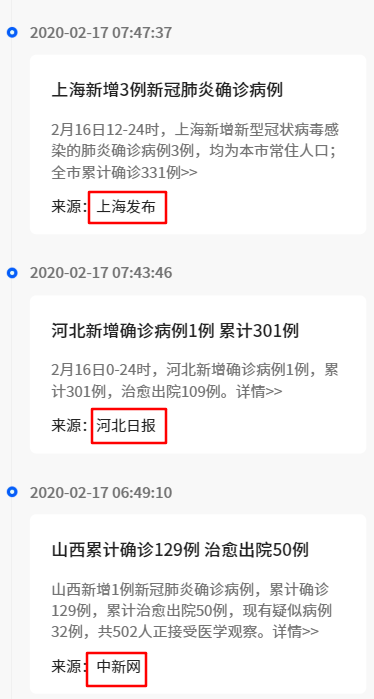
33 条回复 • 2020-02-22 23:34:25 +08:00
 |
1
est 2020 年 2 月 17 日 via Android  3 这个大概率是坐了一个小编
|
 |
2
shanlan 2020 年 2 月 17 日
1.官方 API
2.人肉抓取 3.定制爬虫 |

 |
4
murmur 2020 年 2 月 17 日
官方的新闻直接爬,非官方的人工洗稿
|
 |
5
twor2 2020 年 2 月 17 日
应该是人工的吧,至少半人工
|

 |
8
litmxs 2020 年 2 月 17 日 via Android
就算是人力成本也不是很高吧
|


 |
12
metamask 2020 年 2 月 17 日
不是一套,
一般是先自己搭个框架, 像这种,可以分别写 爬取机制 + 清洗机制(parse ),然后做入库。 像 v 站一个老哥的,pyspider 用来做这玩意就还不错。 |
 |
13
locoz 2020 年 2 月 17 日 via Android
新闻类的直接上智能提取就行了,不用写规则,而且这种需求就无脑刷最新新闻那一页就行。
至于最终发布…显然部分非官方的新闻是人肉处理的,有新闻就直接推到编辑那,审核没问题了再提出关键内容放上去。 |
 |
14
nocoolsandwich 2020 年 2 月 17 日
看你样子是想要疫情的数据吧,github 有人整理好了,数据来源丁香园好像是.https://github.com/BlankerL/DXY-COVID-19-Data
|
 |
15
delectate 2020 年 2 月 17 日
来源就那几个,写规则就好;一般人机器爬,人肉审、二审、发。
|
 |
16
alaikis 2020 年 2 月 17 日
做几个规则,一个源配置一下就好呀,没那复杂
|
 |
19
Ericcccccccc 2020 年 2 月 17 日
人力成本很低啊
|
|
20
locoz 2020 年 2 月 17 日 1
|
 |
21
Mavious 2020 年 2 月 17 日
灰字提要,得人工来提取吧,毕竟新闻也没有固定格式,核心内容还是要人来提取的。
|
 |
22
jingniao 2020 年 2 月 17 日 via Android
丁香园是人工的,因为早上七点之前好像大都不更新。
刚开始那几天好像是小编通宵 /轮班了,晚上也有更新。 |
 |
23
jabin88 2020 年 2 月 17 日
正文提取 算法,不要用正则
|
 |
24
2ME 2020 年 2 月 17 日 via Android
关键词 Readability 识别新闻站的正文进行提取
|
 |
25
herozzm 2020 年 2 月 17 日 via Android
通用爬虫 针每个新闻源定制规则
|
 |
26
wolfan 2020 年 2 月 17 日 via Android
爬微博不就成了😅
|
 |
27
lshero 2020 年 2 月 17 日
有个岗位叫做 值班编辑
|
 |
28
chroming 2020 年 2 月 17 日
专业一点的是用火车头这类工具每个网站写提取规则来爬。要求不高的话找现成正文提取算法直接提取
|
|
29
chroming 2020 年 2 月 17 日
如果只是几个网站的话那人工直接复制更简单
 |
 |
31
ChangQin 2020 年 2 月 17 日
我想爬 twitter 的数据,结果开发者账号好难申请啊。。。
|
 |
32
yinzhili 2020 年 2 月 18 日
这种肯定是人工介入的,怕出问题责任重大
|
 |
33
enrolls 2020 年 2 月 22 日
认真观察网页结构,其实是有通用方法的,印象笔记不是也剪藏了莫。
(顺带测试回复功能) |
推荐学习书目
› Learn Python the Hard Way
Python Sites
› PyPI - Python Package Index
› http://diveintopython.org/toc/index.html
› Pocoo
值得关注的项目
› PyPy
› Celery
› Jinja2
› Read the Docs
› gevent
› pyenv
› virtualenv
› Stackless Python
› Beautiful Soup
› 结巴中文分词
› Green Unicorn
› Sentry
› Shovel
› Pyflakes
› pytest
Python 编程
› pep8 Checker
Styles
› PEP 8
› Google Python Style Guide
› Code Style from The Hitchhiker's Guide